

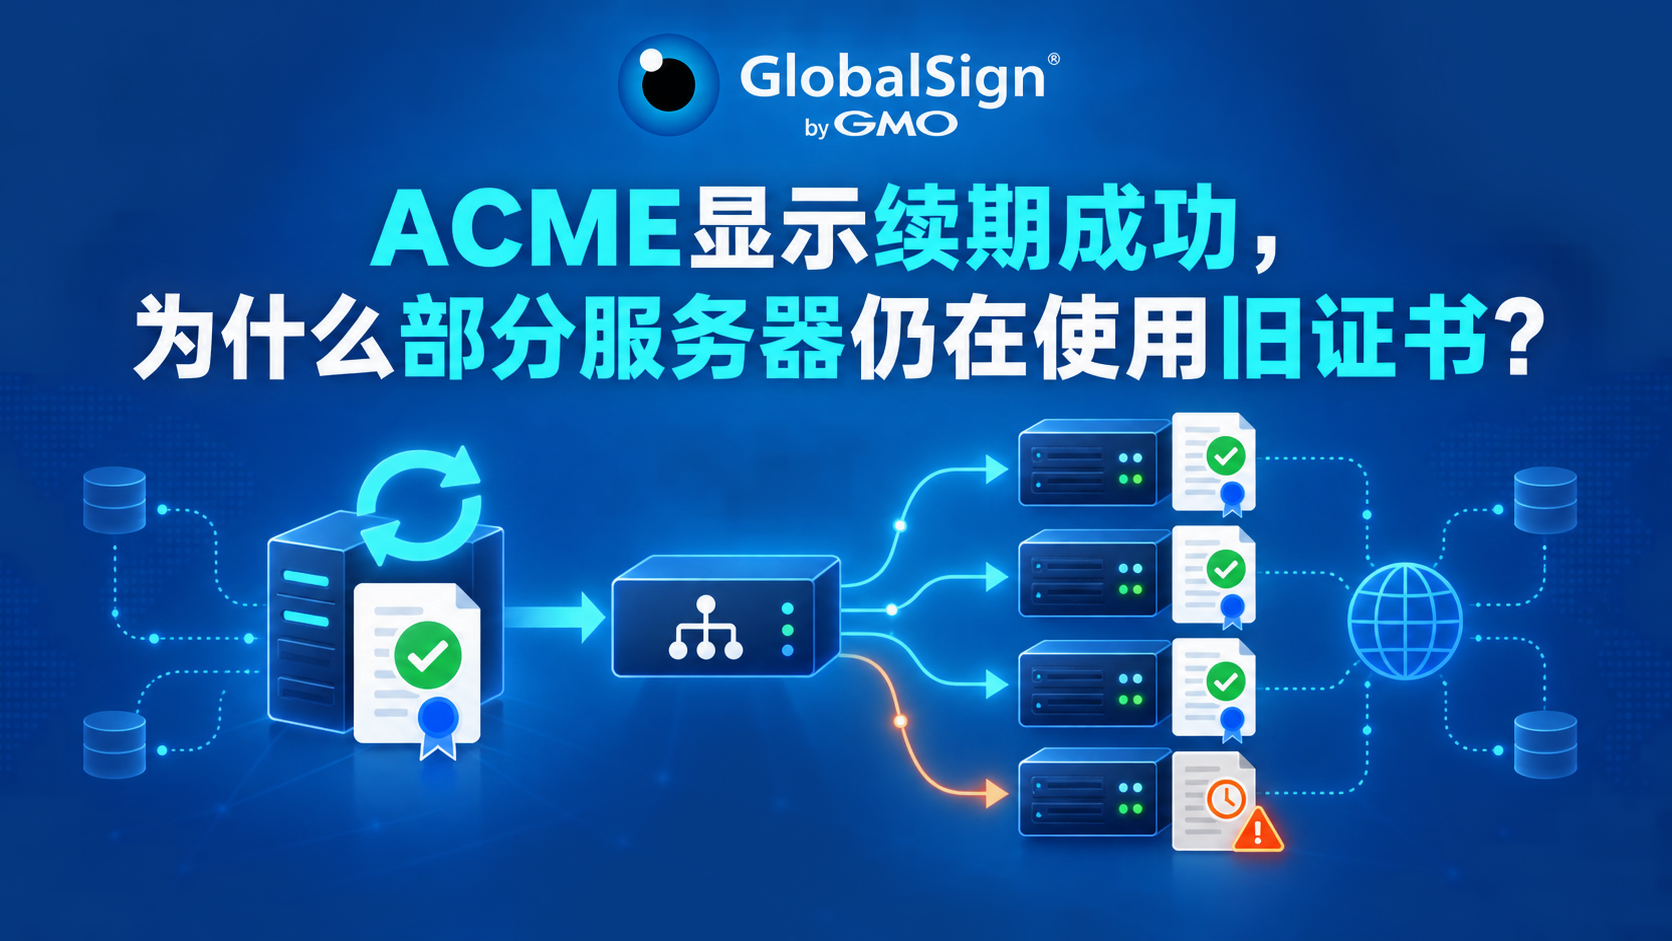
续期日志的最后一行写着签发成功,磁盘上的证书文件也是新的,到期时间往后推了九十天。三天之后,一个节点报警,浏览器提示证书已过期。
这两件事都不假。签发确实完成了,部署确实没发生。问题在于,ACME协议只负责到"把证书交给客户端"为止,至于这张证书有没有装到真正的服务进程里,协议既不定义,也不校验。中间那一步没人验收,失败就是静默的。
ACME 的"成功"只承诺到签发为止
一次标准的订单流程分三段:创建订单、完成挑战验证(HTTP-01或 DNS-01)、签发并下载证书。客户端打印"成功",说的是第三段。
把新证书推送到 Nginx、重载服务、更新 keystore、写进Secret,这些动作不在协议里。它们要么由客户端的 deploy-hook 执行,要么由你自己的分发脚本执行。如果 hook 没配,或者配了但执行失败被忽略,续期主流程照样返回成功码——因为对它来说,任务已经在下载完成的那一刻结束了。
更麻烦的是执行环境。续期大多挂在定时任务里,标准错误没有落盘,那句失败提示打完就没了。等到下一个周期的账单出来,没人会把三周前的一行报错和今天的故障联系起来。
六个根因,按出现频率排
节点清单是静态的:分发脚本里写死了一串主机名,扩容出来的新机器没人加进去。特征是老节点一切正常,只有后上线那几台过期。
服务没有重载:证书文件换了,进程还用着启动时读进内存的那一版。Nginx、Apache需要 reload;跑在 JVM 上的应用从 keystore 读证书,新文件替换之后还得重新导入并重启,光把 PEM 文件丢到目录里没有任何作用;Windows侧的 IIS 绑定的是证书哈希,同样要重新绑定一次。
部署目标指向了旧对象:Ingress 引用的 Secret 名字、CDN上绑定的证书 ID、负载均衡监听器关联的凭证,替换动作可能作用在了另一个环境,或者作用在同名对象上。
只覆盖了入口,没覆盖后端:负载均衡器上的证书是新的,后端几台ECS 上还在跑旧的。双向 TLS 的场景还要多查一处——客户端信任库里的过期条目同样会让握手失败,而这一处往往根本不在任何自动化清单里。
容器没有被触发更新:Secret 内容变了,但Deployment 没有滚动更新,Pod 里挂的还是旧卷;就算卷同步完成(kubelet 的同步存在周期延迟),应用进程通常也不会自动重新加载证书文件。IngressController 侧同样可能有自己的缓存时间。
多入口只更新了一处:同一个域名对外暴露在主站、CDN 回源、备用线路或多个区域,自动化链路只覆盖其中一个。用户被解析到哪条线路不确定,于是表现出"时好时坏"。
为什么坏的是"部分"服务器
这六类并不互斥。清单漏掉了新节点,而那台新节点上恰好跑着需要重新导入keystore 的 Java 服务——一次掉队同时命中两种原因,是很常见的组合。排障时不必急着归类,先把序列号核完,现场往往自己会给出答案。
如果链路完全没通,故障第一天就会被发现,反而是最容易修的。真正消耗时间的是部分成功。
覆盖范围取决于写清单那一天在线的机器,之后上线的设备不会自动加入。灰度发布让新旧版本并存一段时间,落在旧批次上的节点自然收不到更新。失败的任务没有重试队列,也不会有第二次机会,于是每次续期都会新增一批掉队者,比例随时间累积。
每台机器的状态互相独立,除了那份可能已经过时的清单,没有人知道全貌。等到某台机器独自走到到期日,才会用一次故障把这个缺口暴露出来。
别猜,去核对序列号
判断某台机器有没有生效,只有一个可信依据:它当前握手时实际吐出来的那张证书。查的方法很固定:
openssls_client -servername 域名 -connect IP:443 </dev/null 2>/dev/null | opensslx509 -noout -serial -dates -subject
关键在 -connect 后面那个 IP。只测负载均衡的 VIP,拿到的永远是 LB 自己的那张。要把后端每一台的地址逐个跑一遍,包括 CDN回源节点和备用线路。
把输出的序列号与签发记录对比,数字不一致就是没部署。再看一眼notBefore:如果是三个月前的日期,那台机器从上次部署之后就再没更新过。还有一个更快的判据——比对证书文件的修改时间和进程启动时间,文件比进程新,基本可以断定没重载。
这一步不需要多大成本,写成定时巡检脚本,每天把"地址+ 序列号 + 到期日"落一张表,掉队的机器当天就能看见,不用等到浏览器报错。某微软体系的制造企业在接入自动化管理后把季度人工盘点降到了零,前提同样是先把节点清点做干净——看得见才会有后面的治理。
让下一次失败能发出声音
把部署提升为独立任务:不要再让它挂在续期流程的尾巴上。部署单独入队,失败进告警通道,重试要有次数上限和超时。
部署后强制校验四项:中间证书是否齐全、SAN 是否匹配当前域名、端口是否放行、服务进程是否完成重载。只盯到期日的巡检发现不了链路断裂。
节点清单自动发现:证书透明度日志、云厂商资源 API、主机侧上报三路合起来圈定范围。人工维护的清单一定会过期,它过期那天就是下一次故障的起点。
每次操作留痕:谁签发、推到了哪台、什么时候校验通过。这条记录既是排障时的第一手素材,也是审计现场要的东西。
签发入口本身的稳定性是另一回事。GlobalSignAtlas(支持 ACME 协议)提供 99.95% 的平台可用性,签发侧出问题属于小概率事件;真实消耗运维时间的,几乎全都集中在"证书下车之后的那一公里"。
一次排障的先后顺序
先列全入口:域名、所有对外 IP,含 CDN 回源和备用线路,一个都别漏;
逐个地址取序列号,在表里标注新或旧;
对标记为旧的机器,比对证书文件修改时间与进程启动时间;
确认重载动作是否真的执行过:reload 命令、keystore导入、Pod 是否重启;
核查分发脚本的节点清单是否包含这几台,通常到这一步就能看见缺口;
修完之后回到第二步重测,直到整张表的序列号完全一致。
签发成功从来不等于生效。两者之间隔着装载、重载和验收三步,而这三步通常没有监控、没有报警、也没有人签字。把这三步补齐,续期才算真的完成。